Al centro della controversia l'utilizzo di milioni di registrazioni musicali per addestrare l'intelligenza artificiale
Google ha violato il copyright per MusicLM e Lyria?
Una nuova causa legale riaccende il dibattito sull'utilizzo delle opere protette da copyright per addestrare i sistemi di intelligenza artificiale. Questa volta, però, il caso presenta un elemento piuttosto insolito: a portare Google in tribunale è un suo stesso azionista, che ha deciso di agire nell'interesse della società.
Il protagonista della vicenda è Phil Rosen, azionista di Alphabet, la holding che controlla Google.
Il 30 ottobre 2026 Rosen ha depositato presso un tribunale federale di Chicago una causa contro tredici dirigenti e membri del consiglio di amministrazione della società, tra cui il CEO Sundar Pichai e i cofondatori Larry Page e Sergey Brin.
L'accusa riguarda la presunta violazione dei doveri fiduciari da parte dei vertici aziendali, che avrebbero autorizzato una strategia di sviluppo dell'intelligenza artificiale basata sull'utilizzo non autorizzato di materiale protetto da diritto d'autore.
La particolarità dell'iniziativa giudiziaria è che Rosen non agisce per ottenere un risarcimento personale, ma presenta una cosiddetta shareholder derivative lawsuit, un'azione legale promossa da un azionista per conto della stessa società. Eventuali risarcimenti sarebbero quindi destinati ad Alphabet.
MusicLM e Lyria nel mirino: milioni di registrazioni musicali
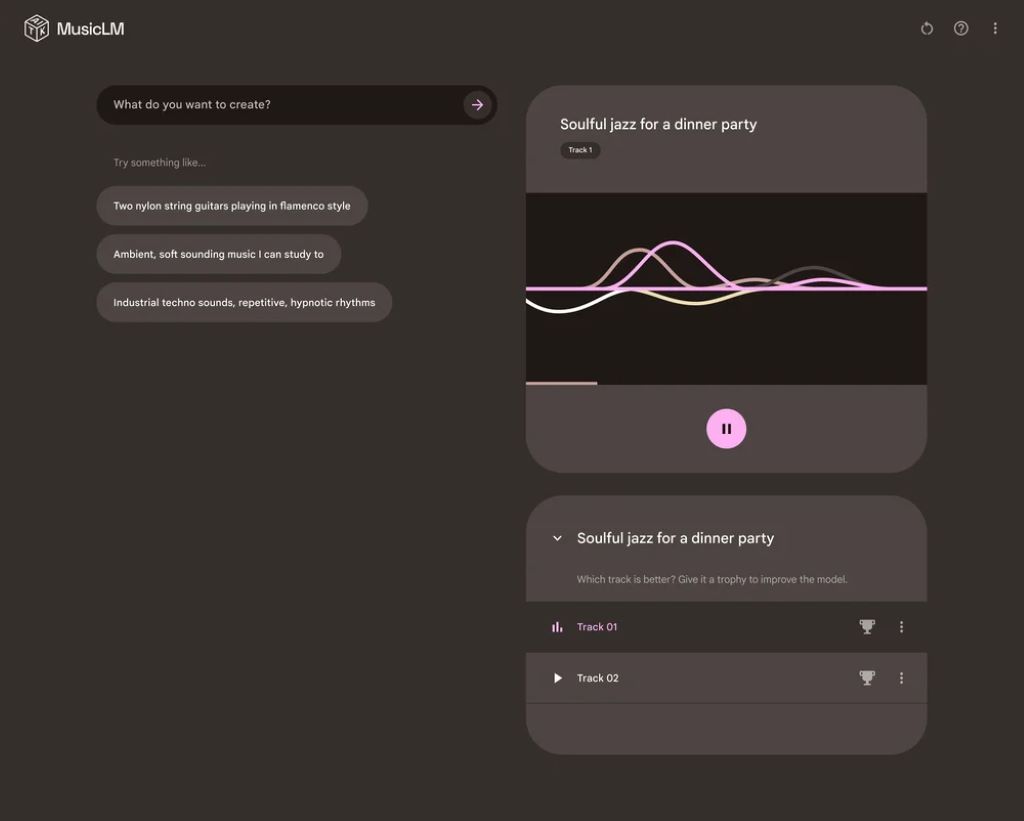
Una parte particolarmente rilevante della denuncia riguarda gli strumenti di generazione musicale sviluppati da Google, in particolare MusicLM e le successive generazioni di Lyria.
Secondo quanto riportato nell'atto giudiziario, Google avrebbe utilizzato milioni di registrazioni sonore, composizioni musicali e testi protetti da copyright per addestrare i propri modelli, attingendo in larga misura anche ai contenuti disponibili su YouTube.
La denuncia sostiene che il materiale sarebbe stato acquisito, elaborato e suddiviso in frammenti audio utilizzabili dai sistemi di apprendimento automatico, senza ottenere le necessarie autorizzazioni dai titolari dei diritti. Viene inoltre contestata la presunta rimozione delle informazioni identificative relative agli artisti e ai rispettivi copyright.
I numeri citati nell'atto sono significativi. MusicLM, presentato nel gennaio 2023, sarebbe stato addestrato utilizzando cinque milioni di frammenti audio, per un totale di circa 280.000 ore di musica.
Secondo Rosen, Google non avrebbe identificato in modo trasparente le registrazioni utilizzate, i rispettivi titolari dei diritti o le licenze necessarie per impiegare quel materiale.
La contestazione non riguarda soltanto MusicLM e Lyria, ma comprende anche Lyria 2, Lyria 3 e il modello Mulan.
La strategia del risarcimento successivo
Uno dei passaggi più significativi della denuncia riguarda la presunta strategia adottata dai vertici di Alphabet.
Secondo Rosen, la società avrebbe preferito evitare i costi e i tempi necessari per ottenere preventivamente licenze e autorizzazioni dai detentori dei diritti, scegliendo invece di affrontare eventuali richieste di risarcimento soltanto dopo l'avvio delle controversie legali.
Una strategia che, sempre secondo l'azionista, avrebbe esposto Alphabet a passività potenzialmente molto elevate.
La causa coinvolge anche altri aspetti dello sviluppo dell'intelligenza artificiale di Google, compreso l'utilizzo di registrazioni vocali umane per servizi come Gemini Live. In questo caso, la denuncia richiama anche la normativa dell'Illinois sulla tutela dei dati biometrici, contestando la presunta raccolta di impronte vocali senza il necessario consenso.
Cosa rischia Alphabet?
La richiesta di Rosen non indica una cifra precisa per i danni, ma punta a ottenere un risarcimento a favore di Alphabet, la restituzione di parte dei compensi percepiti dai dirigenti e una revisione delle procedure di controllo interno, con una supervisione più rigorosa sul rispetto delle normative relative a copyright e dati biometrici.
La denuncia sostiene inoltre che i vertici aziendali avrebbero omesso informazioni rilevanti agli azionisti, anche in relazione alle operazioni di riacquisto di azioni proprie effettuate mentre, secondo l'accusa, la società era già esposta a importanti rischi legali.
È importante precisare che si tratta, al momento, di contestazioni contenute in un atto giudiziario e non di violazioni accertate da un tribunale.
Il caso aggiunge comunque un nuovo capitolo alla complessa relazione tra intelligenza artificiale e industria musicale. L'utilizzo delle registrazioni esistenti per addestrare modelli generativi continua infatti a sollevare interrogativi sulla tutela degli autori, sulla remunerazione degli artisti e sulla necessità di definire regole più chiare per l'impiego dei cataloghi musicali.
Per Google, la questione potrebbe avere conseguenze che vanno ben oltre MusicLM e Lyria, mettendo sotto esame le modalità con cui uno dei maggiori protagonisti dell'intelligenza artificiale ha costruito parte delle proprie tecnologie.
Vi terremo aggiornati sugli sviluppi futuri.